定义:将数据拆分并存储到不同机器上。
优点:
- 常用数据放到更强的硬件上,增强读性能。
- 按地域分区数据,增快区域性的读写。
- 单纯增强读写的性能。
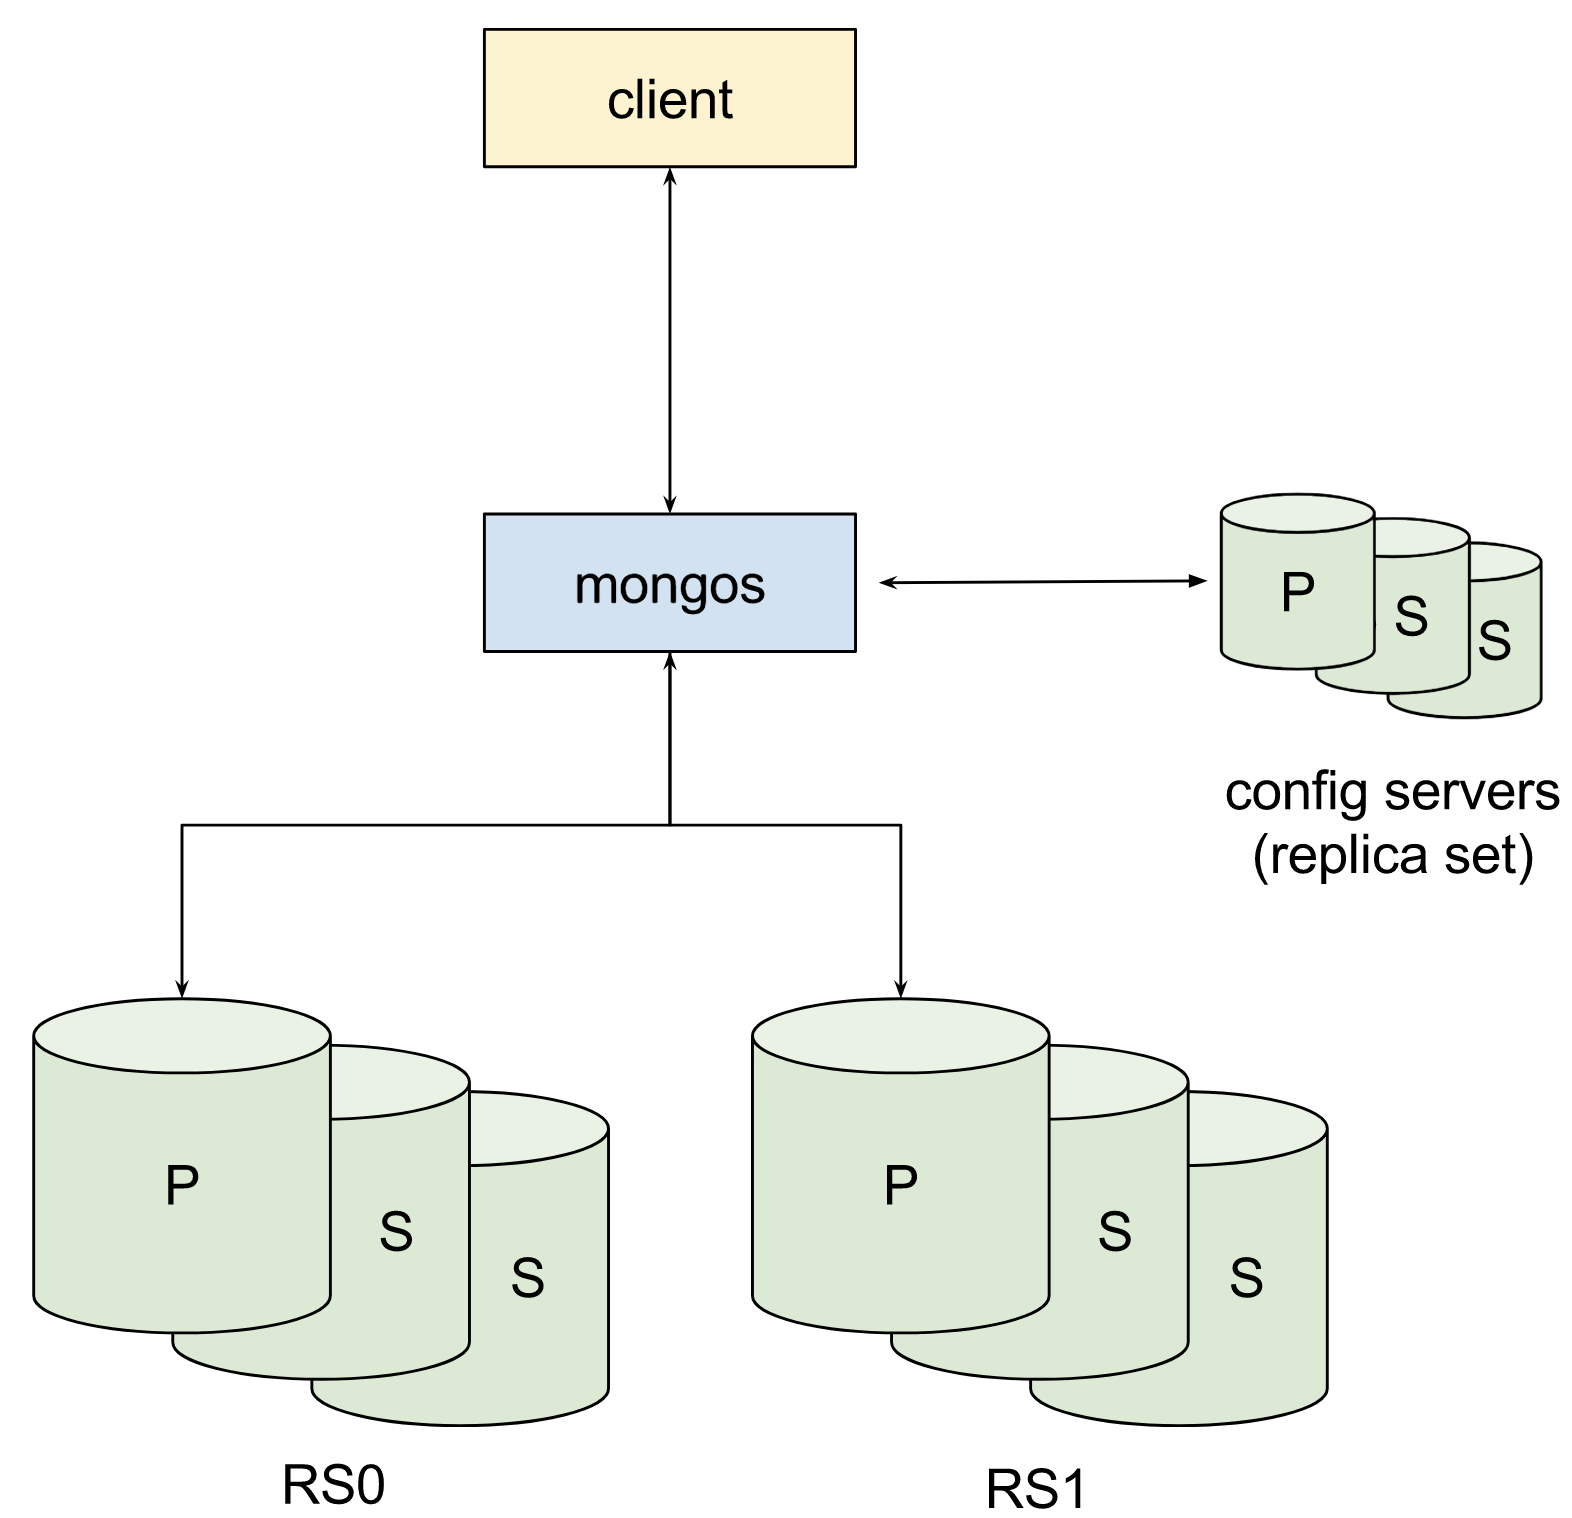
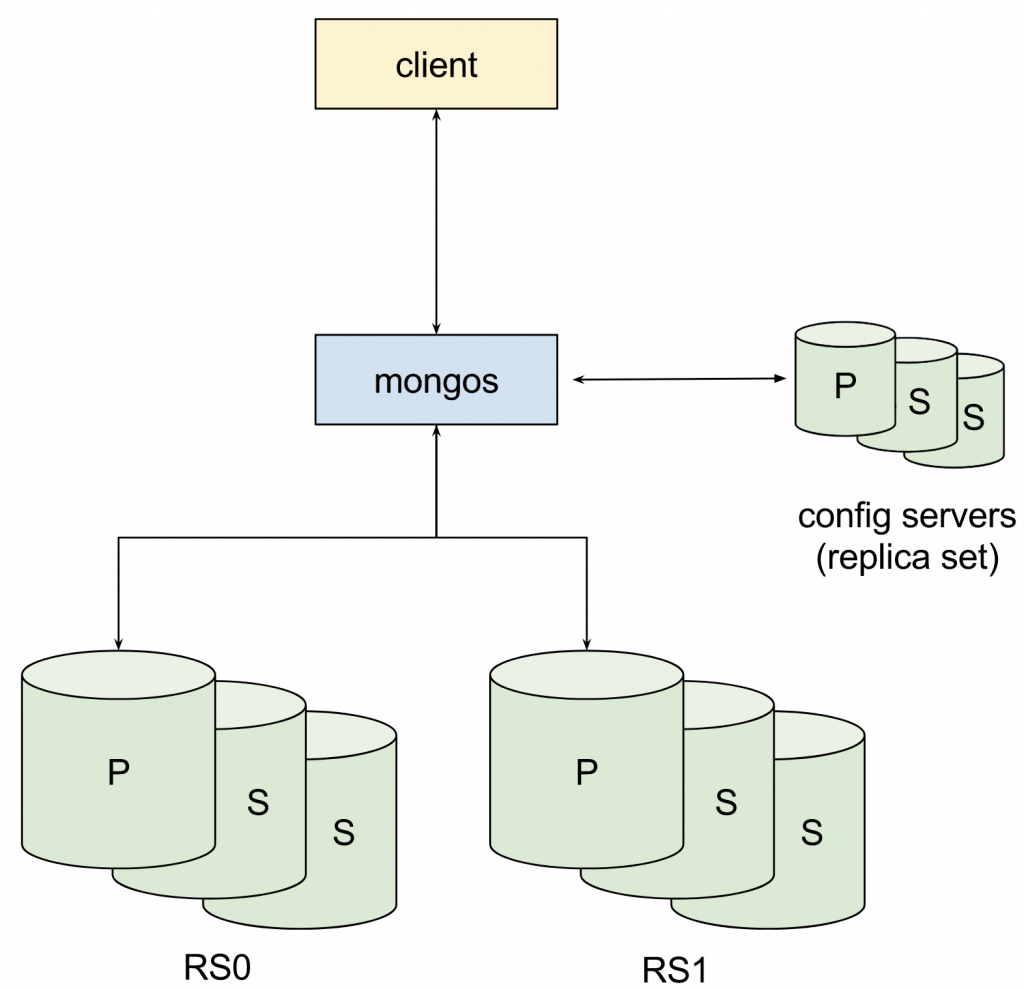
架构图:
Mongos
客户端与mongos连接,作为集群前台响应客户端请求。mongos可以拉取/修改config server中存放的元数据。
mongos本身不存放元数据,只在启动时拉取到mongos内存中。
当config server不可用时,monogs即无法修改元数据。但仍有可能继续正常工作一段时间。
当客户端需要从多个shard读取数据时, mongos负责收集从所有shard数据,再返回给客户端。
初始化mongos
为mongos配置config servers:
mongos –configdb configRS/cfg1.example.net:27019,cfg2.example.net:27019,cfg3.example.net:27019 \–bind_ip localhost,198.51.100.100 –logpath /var/log/mongos.log
通过mongos为shard集群配置添加shard servers:
sh.addShard(“rs0/svr1.example.net:27017,svr2.example.net:27017,svr3.example.net:27017” )
手动强制使mongos和config server同步:
db.adminCommand({“flushRouterConfig” : 1})
运行mongos的数量:
- 一般,我们在一个application server上运行一个mongos。
- mongos不是越多越好,mongos会与集群中所有节点建立通讯连接通道,增加了网络开销。
Config servers
Config servers实质为一个专门用来存放sharding集群元数据的replica set或者standalone-server。
- 必须使用WT engine
- 为了保证数据不丢失需要在config server上开启journal功能。
- 生产环境最好使用replica set(最少3个节点)的形式来组建config server。
- 写入Config server使用Write concern majority来保证数据在一定数量的主从节点之间的一致。当宕机发生时,至少有一台机器拥有最新的数据。
- 读取Config server使用read concern majority 来保证读取的数据在一定数量的主从节点之间的一致
- 1KB元数据大约相当于20MB存储在shard server上的数据。因为config server不是很消耗资源,一定情况下可以考虑放到弱性能服务器上。
config server中的数据库
admin 数据库存有权限相关的collection数据
other system.* collections for internal use
config 数据库存有 sharded cluster 的元数据
配置启动config server
启动mongd时,使用–configsvr即指定为config server
mongod –configsvr –replSet configRS –bind_ip localhost,198.51.100.51
初始化config server的replica set,也需要使用configsvr参数:
rs.initiate( {
_id: “configRS”,
configsvr: true,
members: [
{ _id : 0, host : “cfg1.example.net:27019” },
{ _id : 1, host : “cfg2.example.net:27019” },
{ _id : 2, host : “cfg3.example.net:27019” } ] })
Shard Servers:
正真存放数据的replica set。
配置启动shard server
启动mongd时,使用–shardsvr 即指定为shard server
mongod –replSet “rs0” –shardsvr –port 27017 –bind_ip localhost,<ip address of member>
移除shard:
移除时数据会从这个shard 迁移到其他shard上去(意味着消耗很多时间,和硬件资源) 移除shard的时候一定要确保balancer是开启的!
db.adminCommand({“removeShard” : “shard03”}) –(remove开始后,如果再次运行这个命令,可以查看remove的进程)
如果该SHARD是某个数据库的primary shard的话需要移除primary shard
db.adminCommand({“movePrimary” : “video”, “to” : “shard01”})
Primary Shard
一个shard是一个replica set。对于一个数据库,用来存放没有sharding 的collection的replica set,就是primary shard。
启动sharding:
对于某个数据库启用sharding:
sh.enableSharding(“accounts”)
对于shard key创建索引(必须)
db.users.createIndex({“username” : 1})
注意:
1.对于数据已经存在的collection, 没有对应索引, shardCollection 会报错
2.对于不存在的collection, shardcollection会自动创建对应的索引
Shard collection:
sh.shardCollection(“accounts.users”, {“username” : 1})
查看sharding集群的状态:
sh.status()
targeted queries:需要访问单个或多个shard但不是全部shard的query
scatter-gather queries: 需要访问所有shard的query
只访问单个shard的查询,执行计划显示为: “stage” : “SINGLE_SHARD”。两个以上则为” stage”:”SHARD_MERGE”
Chunks:
在sharding中,chunks是存放相同或一定范围sharding key值的数据的单元。
在非sharding的collection中,数据存放就是一个single chunk。
chunk不是物理上硬盘上的区别,而逻辑是的区别。所以split chunk实质上也只是元数据上的改变。
一个新的shard collection从一个single chunk 开始。
config server上存放chunk相关元数据信息的collection: config.chunks
在手动处理chunk或者控制sharding之前:我们需要关闭balancer
查看chunk:
db.chunks.find() //查看集群上所有chunk
sh.status(true) //查看 集群上所有chunk
sh.splitFind( “records.people”, { “zipcode”: “63109” } ) //查询特定shard key值的结果在哪个chunk 上
手动移动chunk:
sh.moveChunk(“video.movies”, {imdbId: 500000}, “shard02”)
移动的时存有 imdbId: 500000 的chunk这里并不是表示范围或者取值。 使用shard key值的范围下界来表示chunk。
如果被移动的chunk容量大于现有的max chunk szie 移动会被拒绝。需要手动切割chunk(也有不能被切割的chunk, Jumbo chunks)。或者,调整max chunk size来chunk可以被移动。
手动切割chunk:
sh.splitAt(“video.movies”, {“imdbId”: NumberLong(“7000000000000000000”)})
调整max chunk size:
db.settings.findOne() 查看大小
db.settings.save({“_id” : “chunksize”, “value” : 32})
1. 缩小size,现有chunk不会马上修改大小,只有在insert,update发生时才对应的chunk才会修改。
2. 增加chunk size时,即使有”写操作”发生。chunk不会合并。只会在现有基础上追加数据。
合并chunk :
db.adminCommand( {
mergeChunks: “test.members”,
bounds: [
{ “username” : “user69816” }, //下届
{ “username” : “user96401” } //上届
] } )
Jumbo chunks:
不可移动不可切割且超过了max chunk size的chunk。
为什么会有jumbo chunks:
比如: 按日期建立的shard,一天作为一个chunk。当有一天数据量很大,chunk存放的数据超过了max chunk size的时候。
当一个shard增长的比其他shard都快的很多的时候,很可能就有jumbo chunks了。因为大多数的数据往一个shard写,该shard的chunks不断split,最终肯定会达到无法分割的状态。
查看 jumbo chunks:
sh.status()里对于jumbo chunks也会有标记。
处理方法:
- 先关闭balancer,
- 手动设置max chunk size最大的大小为jumbo chunk可以被移动,
- 移动jumbo chunk到合适的shard上,
- 手动切割集群的其他chunks,让chunk数量在节点上均匀。(防止balancer启动后发现chunk不平衡,开始疯狂移动集群中的chunks)
- 调整回原来max chunk size设定。
- 最后启动balancer
避免方法:
原理:增加shard key的粒度,这样数据在保存的时候就被细分到更小的chunk上。
- 比如日期,增加粒度到,小时/分钟/秒
- 组合键,使用其他更细粒度得值来做第二位shard key。使数据在第二位KEY上不断增加的同时依然能够被split。
mongos 对于chunks的控制
一、Balancer:
任何一个mongos都有机会/可能充当balancer的角色。balancer通过每个shard server上chunks的数量(不是数据容量)来判断chunks分布是否均匀。如果balancer发现 chunks 在shards上存储的不平衡,那么就会尝试迁移chunks使数据分布“均匀”。
技巧1:balancing window, 在特定的时候启动balancer来平衡数据,可以避免自动平衡带来的服务器性能影响
balancer相关元数据存放在config.locks collection中
查看哪一个mongos是balancer: 0 失效,1 尝试成为balancer,2工作中
db.locks.findOne({“_id” : “balancer”})
关闭/开启balancer:
sh.setBalancerState(false) –false为关
sh.stopBalancer(): //如果有正在进行的migration,会等到结束再停止balancer
注意:
关闭balancer的目的往往是由需求人为控制sharding的分布
查看balancer是否在运行处理:
sh.isBalancerRunning()
或
db.locks.find({“_id” : “balancer”})[“state”]
技巧:可以在业务重的时候关闭balancer,然后在业务少的窗口期开始balancer来达到期间相对平衡的数据分布。
二、自动切割chunks:
mongos启动后会有counter来记录具体shard key值对应的chunk是否需要被split,达到阈值就会通知config server要split chunks.
注意:
- 当config server 宕机的话,mongos任然会持续连接/尝试让config server split,会对mongos服务器造成压力。
- mongos检测到有需要split而Config server不可用时,会疯狂尝试通知config server的行为,叫做 split storm
- mongos一旦重启,counter就会被清0。如果被频繁重启的话,可能造成chunks永远无法被mongos检测到需要被split。(这时候,你可能需要考虑设置比较小的max chunks size,让系统自动因为size问题,split chunks,增加被切割的频率/可能性。)
–nosplit 启动参数 : 控制mongos,不自动做split。
三、Chunk Migration:
- Migrates indexes. If this shard has never held chunks from the migrated collection before, it needs to know what fields are indexed.
- Deletes any existing data in the chunk range. There might be data left over from a failed migration or restore procedure which we wouldn’t want to interfere with the current data.
- Copies all documents
- Replays any operations that happened to these document during the copy (on the “to” shard)
- migrated data to a majority of servers
- changing the chunk’s metadata to say that it lives on the “to” shardconfig.tags