Create Index:
db.users.createIndex({“username” : 1})
db.users.ensureIndex({“age” : 1, “username” : 1}) //ensureIndex 3.0版本之后,只是createIndex的别名。
Drop Index:
Db.test.dropIndex({year:1})
Background: true 属性,通过间断性的释放lock, 减少对系统性能的影响。
db.employee.createIndex({year:1}, {background: true})
为Index命名
db.soup.createIndex({“a” : 1, “b” : 1, “c” : 1, …, “z” : 1}, {“name” : “alphabet”})
查询collection已有哪些Indexes
db.collectionName.getIndexes()
建立index的时候可以指定名字(一般没有必要,系统会自动按规则生成可读的名字)
各类Index:
Geospatial Indexes
Mongodb对地理的索引支持很强大,除如何创建geoJSON对象,建立不同类型的对象,使用$near,$geointersection查询外。在学习时选择了跳过很多内容,没有深入学习。这里就不列出笔记。
代码:
建立INDEX:
db.openStreetMap.createIndex({“loc” : “2dsphere”})
Compound index:
Sort是否能使用compound index,取决于sort字段与index字段的顺序。
When designing a compound index:
Keys for equality filters should appear first.
Keys used for sorting should appear before multi-value fields.
Keys for multi-value filters should appear last.
try to create indexes on high-cardinality keys or at least put high-cardinality keys first in compound indexes (before low-cardinality keys).
一句话总结设计的原则就是,需要准确匹配的或者排序的放在前面,有多个值或者说范围值的放在最后。
Index影响是否需要在内存中进行sort
代码:
db.users.ensureIndex({“age” : 1, “username” : 1})
FIND1: db.users.find({“age” : 21}).sort({“username” : -1})
FIND2: db.users.find({“age” : {“$gte” : 21, “$lte” : 30}})
FIND3: db.users.find({“age” : {“$gte” : 21, “$lte” : 30}}).sort({“username” : 1})
FIND1,FIND2都不会导致需要在内存中排序。FIND1中排序的顺序,并不会使结果需要到内存去排序(可以直接(反顺序)把结果放到内存里面)。FIND2更为一个普通的利用compound index的查询,同时也没有要求排序。
FIND3,在FIND2的基础上要求了排序。实际为:以FIND2的结果为基础,再以USERNAME排序。需要注意到的是,FIND2出来的结果可能是以AGE为主序的,那么username就是乱的(也没办法在插入内存之前整理好顺序再放入内存)。那么就需要一个内存中的SORT了。
note: 值得注意的就是,如果创建INDEX 的时候KEY的顺序是,{“username” : 1, “age” : 1}。那么FIND3,就不需要在内存中SORT了。
Compound unique index:
组合必须唯一,单列可以重复。 最多32个字段联合
Unique index:
列只能含有唯一值,否则插入会报错。但是,就性能考虑不能使用这个机制来处理大量的重复数据
db.users.ensureIndex({“username” : 1}, {“unique” : true})
注意:
1.如果建立索引这个field的key不存在,这样创建后,当插入数据有2条以上没有这个field key,也会报错。(也就是null值也被视为一种重复)
2. key: 长度不能超过8KB
3. 如果在replicate sets中建立唯一索引,需要确保数据没有重复,否则重复值错误在secondary产生后,secondary会自动关闭。需要手动重启和修复重复值的操作。
db.people.ensureIndex({“username” : 1}, {“unique” : true, “dropDups” : true})
作用: 创建唯一索引,如果有field重复的document,保留第一个获取到的,删除其他。(无法控制/返回一个结果集告诉你删除的时候哪些)
Sparse Index:
即创建索引的时候,忽略NULL值,或者NULL KEY。不会把field 为NULL值的document放到索引中
db.users.ensureIndex({“email” : 1}, {“unique” : true, “sparse” : true})
注意:
1. 解决唯一索引NULL重复的问题的同时,通过索引查询出的结果,也不会含有NULL
2. 通过如果忽略了NULL值,那么sort的时候,sparse index 也不会被使用。
3. 默认为sparse index的index。2dsphere (version 2),?2d,?geoHaystack, ?text?
Hashed Indexes
把所有值使用hash值来存储建立索引,只能建立在单列上。
Text indexes:
支持文本检索查询的INDEX。 创建这种索引非常消耗时间,建立的时候最好一次只同时建立一个。
对所有的string类型列生成TEXT INDEX:
db.articles.createIndex({“$**” : “text”})
创建text index时候可以给weights(不过index的weight 是什么作用呢?)
db.articles.createIndex({“title”: “text”, “body”: “text”}, {“weights” : { “title” : 3, “body” : 2}})
注意:weights只能在创建索引的时候设定,不能改变。修改只能drop & create
textScore 为TEXT INDEXES的元数据,表示搜索结果与关键词的相关程度(这里也就能明白,前面建立索引时,给的weight是干嘛用的了),元数据默认是隐藏不显示的,但是可以使用$meta 取出行对应的元数据:
db.articles.find({$text: {$search: “\”impact crater\” lunar meteor”}}, {title: 1, score: {$meta: “textScore”}}).limit(10)
注意:
1.如果使用aggregation pipeline的话,可以通过对score排序来按照结果的匹配度返回结果。
2. \”impact crater\” 与 (lunar OR meteor) 为AND 关系
分词是否大小写敏感:
db.employee.find({$text:{$search: “\”war room\””, “$caseSensitive”:true}}
按语言分词
新建索引时指定默认的分词语言:
db.users.createIndex({“profil” : “text”, “intérêts” : “text”}, {“default_language” : “french”})
插入新的数据时,指定分词语言:
db.users.insert({“username” : “swedishChef”,”profile” : “Bork de bork”, language : “swedish”})
TTL Indexes:
顾名思义,有时效的index。 应用场景可以时类似于,缓存session。只能是1列。
注意:MONGODB对TTL Index的检查时1分钟一次的,所以对于小于这个量级的TTL过期其实是不可靠的,TTL index可能存在超过1分钟。同时如果索引列为非时间/日期类型,该TTL Indexes永不过期。如果索引列为数据类型为时间/日期数组,过期时间计算以数组中最小值为计算基础。
db.sessions.createIndex({“lastUpdated” : 1}, {“expireAfterSeconds” : 606024})
修改有效期:db.runCommand( {“collMod” : “someapp.cache” , “index” : { “keyPattern” : {“lastUpdated” : 1} , “expireAfterSeconds” : 3600 } } );
Covered Index
定义:只需要使用index就可以满足查询的所有结果。
注意: 含有数组的 index,那么不能被用作一个covered index 。否则即使查询时去掉arrar 对应的field也无法达到covered index(原因很简单,有array的index建立存储的方式和普通的不一样了。)
Mongodb是如何选择INDEX
在系统没有任何执行计划cache的情况下,mongodb会先选出符合QUERY shape的index,然后分别(并行)执行,最先返回100条结果的即为winning plan。最后用winning plan来执行query。
在系统有这个query的执行计划cache(第一次执行的时候的winning plan 会被cache下来)的时候,Mongodb会优先使用cache。
cache什么时候失效(mongodb对是否使用cache的评估):
1.有新的index 建立/重建/删除
2.每执行1000次query
3.collection中数据达到一定量的改变(具体多少,还没有找到相关信息)
4.服务器重启
Hint强制mongodb使用某个index
代码:
db.c.find({“age” : 14, “username” : /.*/}).hint({“username” : 1, “age” : 1})
Hint强制mongodb “不 ”使用某个index
代码:
db.c.find({“age” : 14, “username” : /.*/}).hint({“$natural” : 1})
注意:
在不同引擎上,$natural 代表的实际顺序是不一样的。$natural, 表面实际意义为表不进行任何排序的顺序。
1.在WT上,为插入顺序。
2.在MMAPv1上,为磁盘上存储的顺序。
Cursor
- BasicCursor — 正常表
- BtreeCursor –普通index
- Other—-其他特殊indexes, 比如 geospatial indexes 拥有自己的curosr
减少在embedded docs 或 array上建立index
- 在embedded docs上建立index,对把embedded docs整个对象左右检索对象有用
- 在array上建立index,是对array中每一个对象建立索引。(Size:100,就需要建立100个索引记录。)
- 一个index里只能含有一个ARRAY field,否则会出现笛卡儿积(可怕的数据量。。)
Index limits:
- field的大小需要小于1MB。否则,field在INDEX中记录会失败,但是系统不会提示任何错误(按INDEX来查询的时候,你也就查不到对应记录。只能指定不使用index来查询到想要的结果)
- 先插入结果,再生成index效率更高。
- 与集群拥有不同index的节点,不能成为primary。priority应该设置为0。
index阻塞所有读写任务
- index建立时,会阻塞所有读写任务,database level!! —所以需要使用background option在生产环境来建立INDEX。
- 阻塞所有读写任务可能会时,replication/sharding 集群出现崩溃的情况。(A开始生成索引,B通过raplicate也开始生成索引,然后C,D,E….最后一个集群崩溃了。)
优化技巧
- $ne, 一般会使用table scan
- $not, 有的时候不会使用index。如果是数字类型,可以使用 $lt + $get 来代替
- $nin, 使用table scan
- $or, 使用$or有的情况下使得查询能使用多个index来提升性能( “$or” can use one index per $or clause, as $or preforms two queries and then merges the results )
- $in, 但在有的时候, $in 会比$or性能更好,因为$or把一个查询分成了多个查询再合并结果。
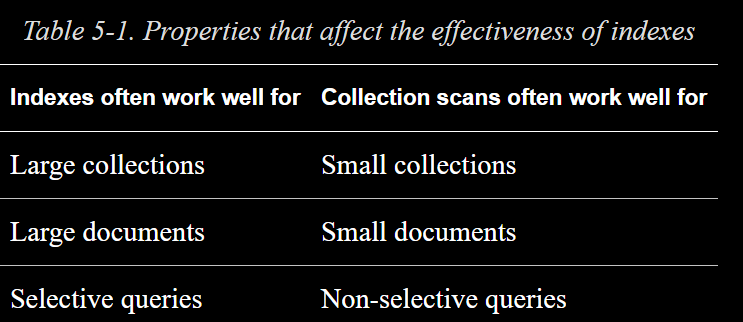
- 因为,index相当于两次lookup,如果数据量足够小,或者是全表查询的话,其实有index实际可能会更慢一些。需要根据你的数据量和查询方式来做判断。
- 在compound index,使用一个列对数据进行分组,再查找第二列的数据可以帮助缩小查询的数据量(比如:full-text的查询,使用日期分组)